Przeszukaj forum
Pokazywanie wyników dla tagów 'soft-cpu'.
Znaleziono 1 wynik
-
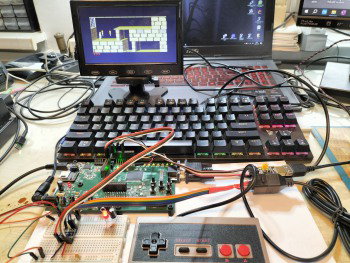
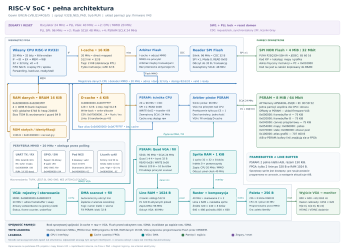
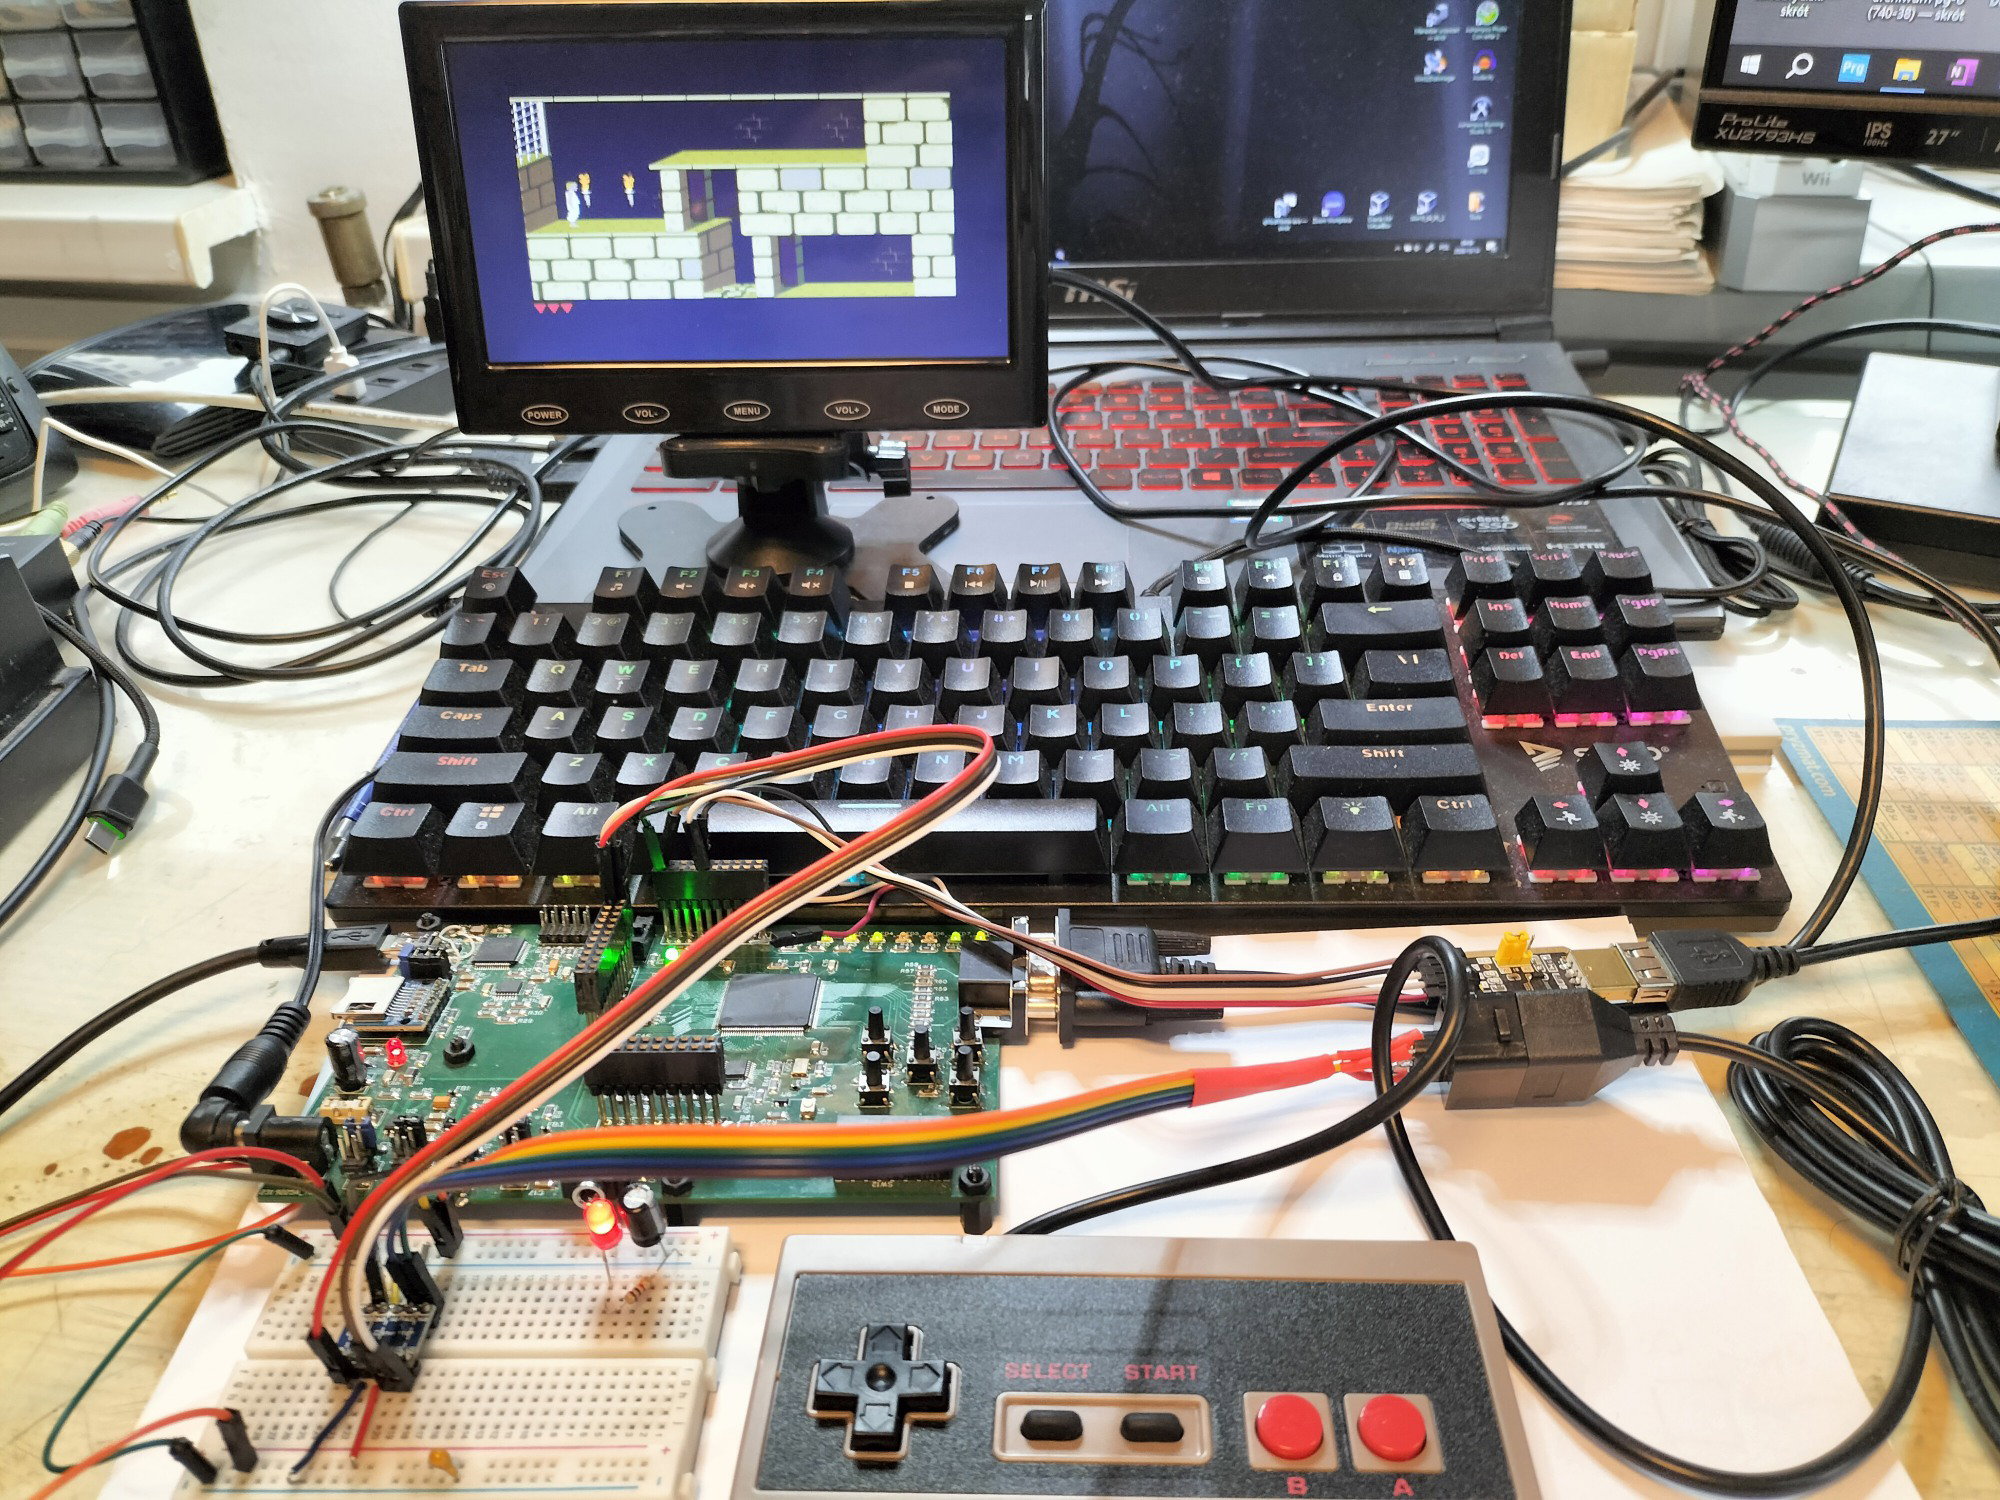
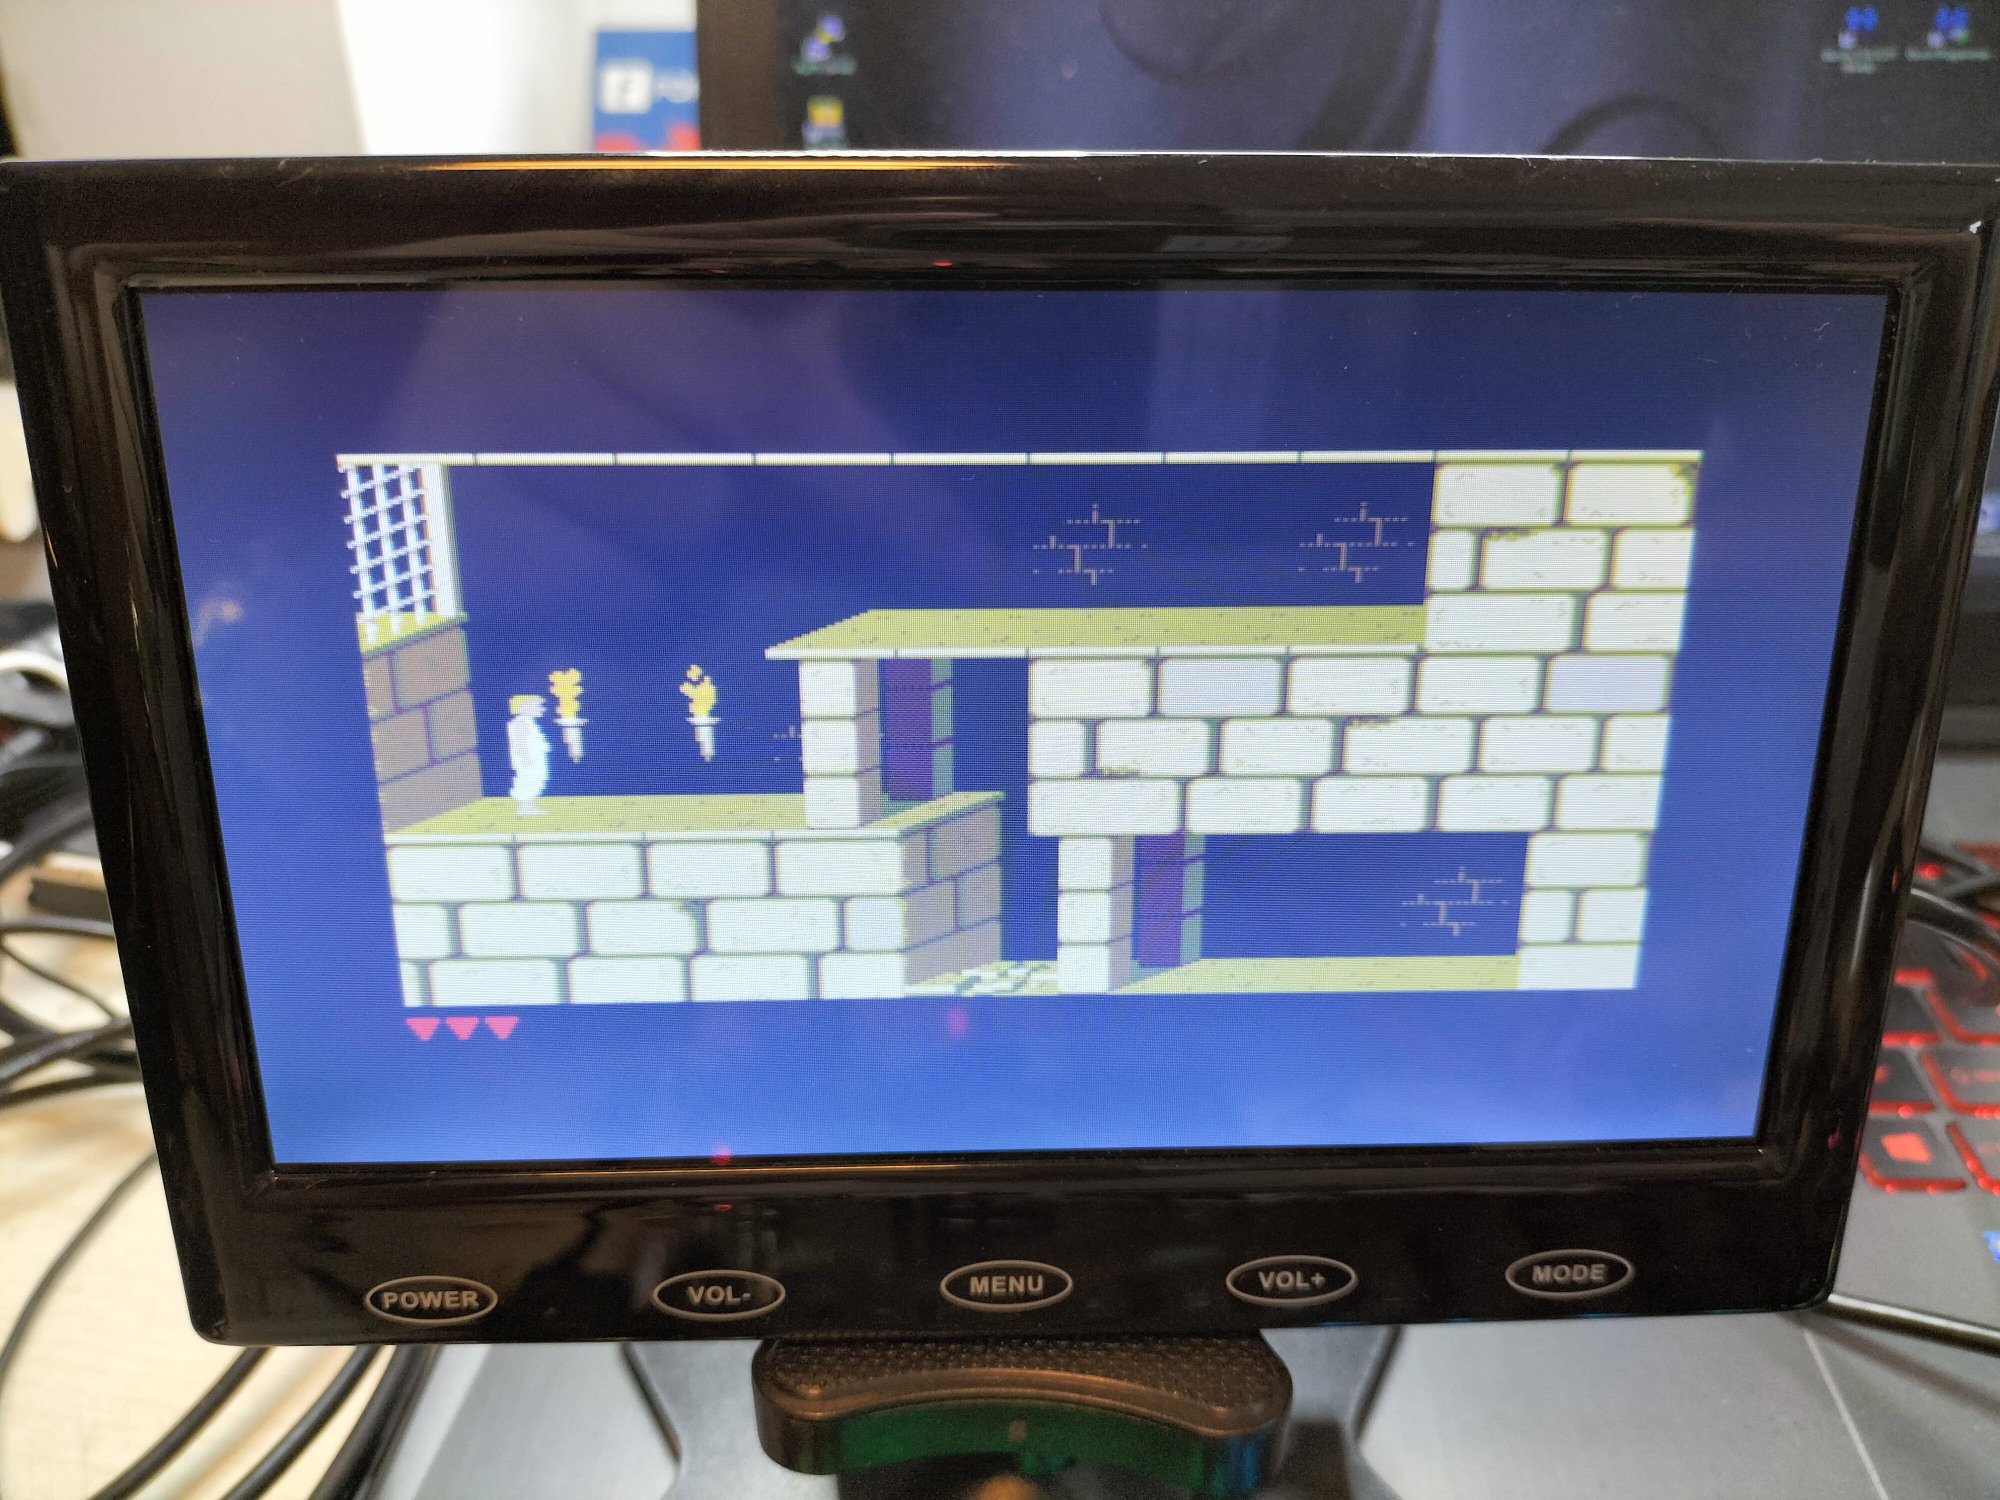
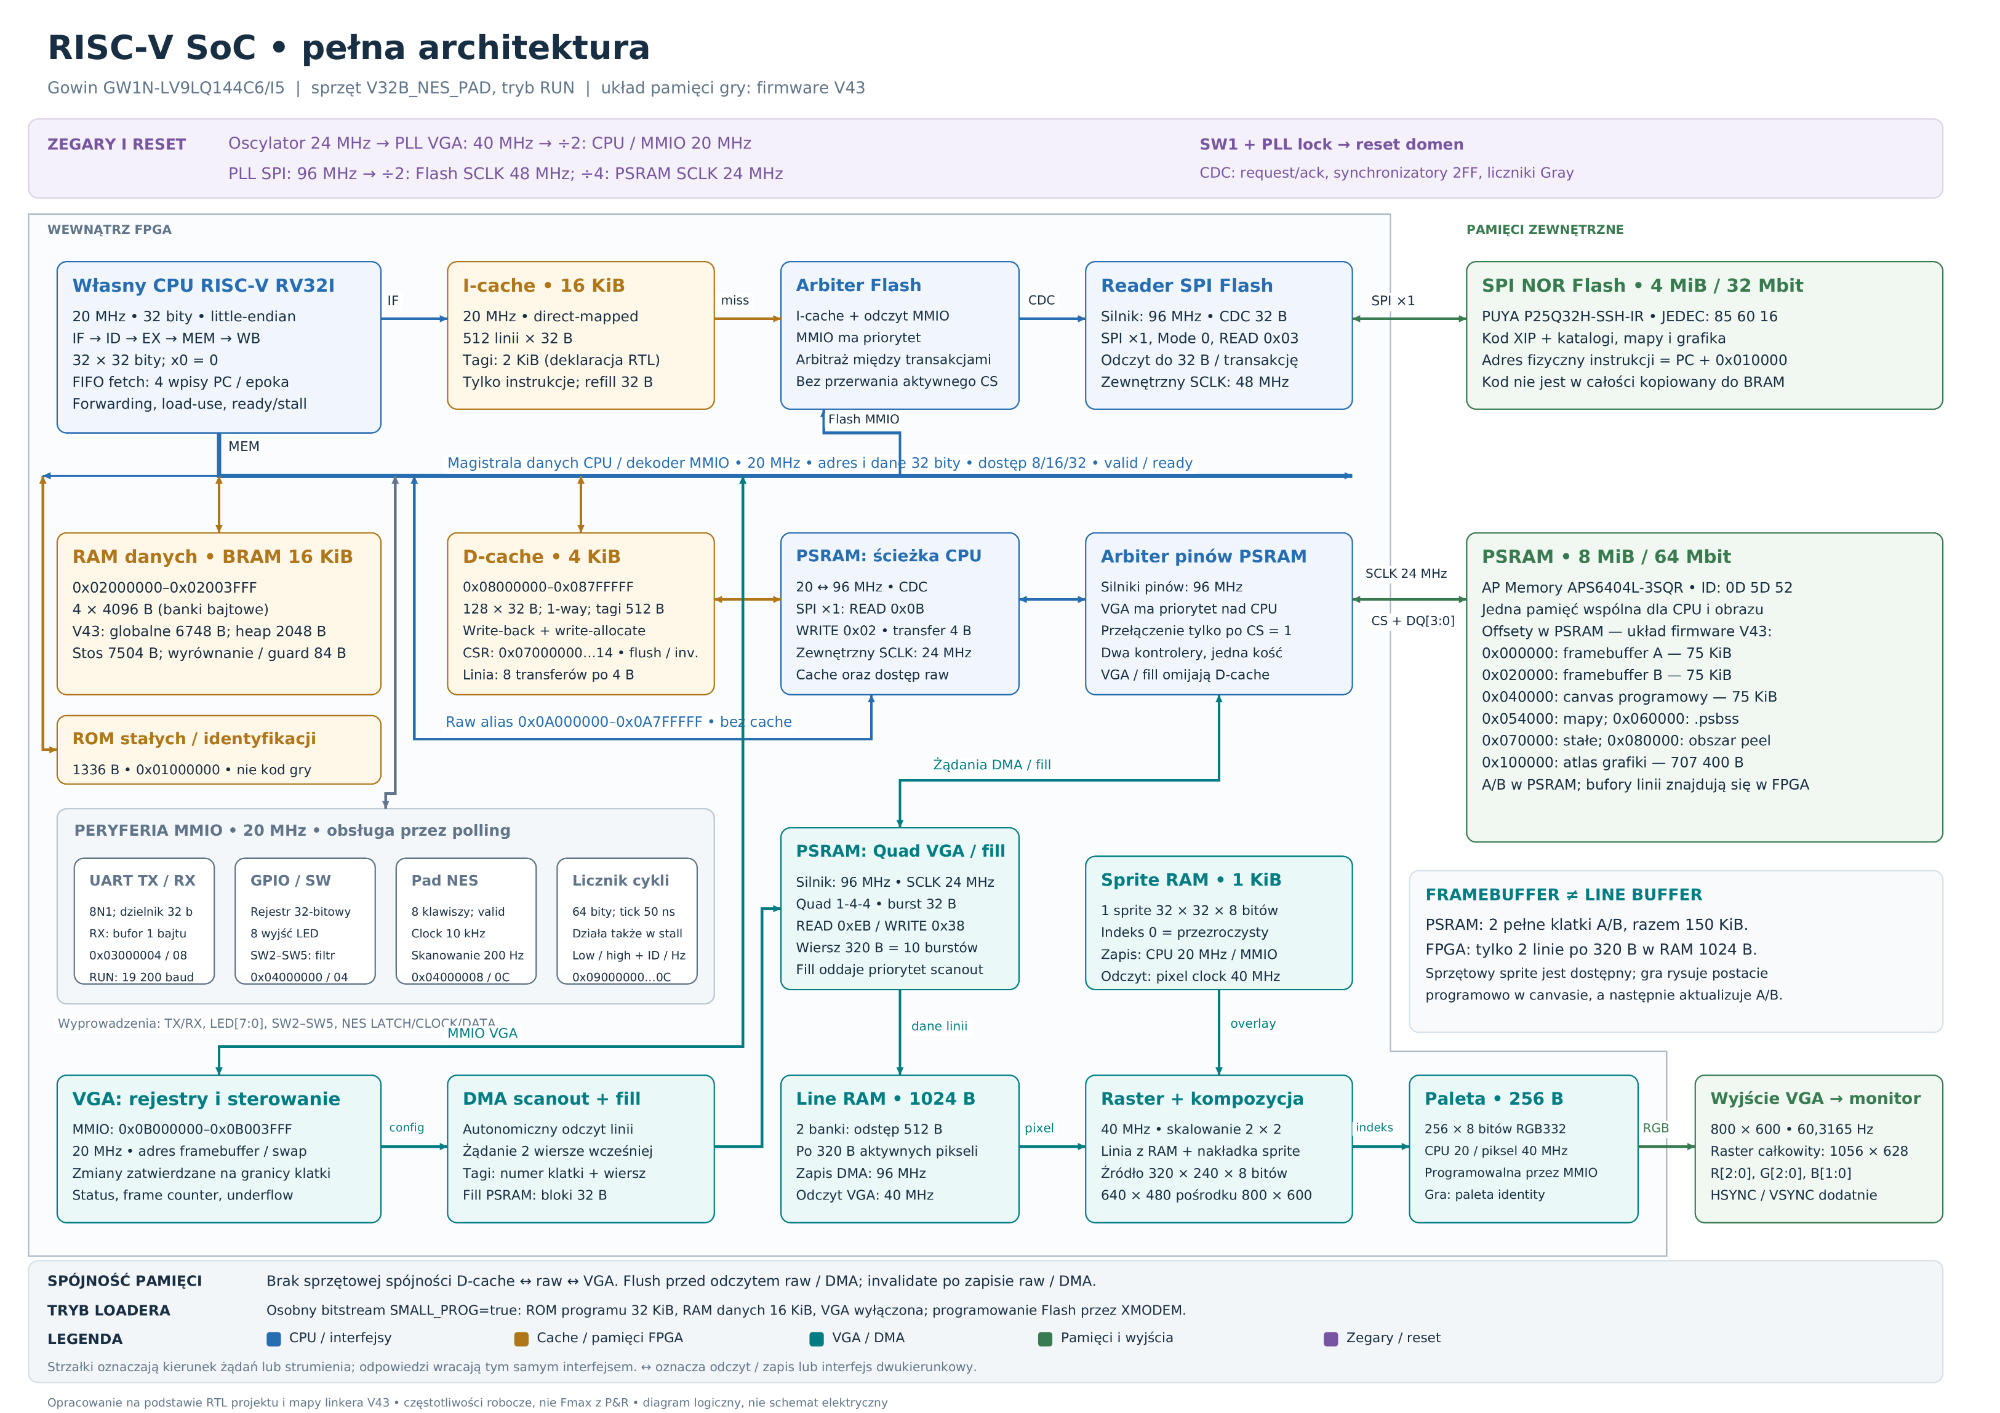
 Cześć, przez ostatnie 2 lata miałem tyle projektów w pracy (i takie tempo), że w ogóle nie chciało mi się zamieszczać żadnych projektów elektronicznych na forum. Teraz wracam i zacznę od tematu "z grubej rury". W tym dziale forum "Forbot.pl" było zamieszczone kilka projektów soft-procesorów, ale wszystko były to bardze proste procesory (zaimplementowane kilka instrukcji CPU) o małej wydajności i bez obsługi kompilatora języka C. Wiekszośc z nich nie miała zaimplementowanych żadnych bloków do komunikacji ze światem zewnętrznym (chociażby UART) czy obsługi pinów GPIO. Więszość zamieszczonych w sieci projektów soft-processorów miała bardzo małe pamięci programu np. 1 KB i pamięci RAM, oraz brak obsługi kompilatora języka C co wykluczało ich zastosowanie w praktycznych projektach elektronicznych. Istotne jest także to aby soft-processor nie zajmował za dużo zasobów układy FPGA, żeby można go zaimplementować na małych układach FPGA (cena FPGA jest tu istotna). Nakreśliłem tutaj przyczyny małej przydatności soft-processora do praktycznych projketów. Opisywany tutaj projekt a właściwie kilka projektów jest rozległy i będę opisywał go tutaj etapami. Docelowo postało tutaj kilka soft-CPU o róznych projektach do różnych zastosowań i są to właściwie SOC bo mają peryferia takie jak UART, GPIO i kontroler pada do starych konsoli NES. Aby sprawdzić wydajność powstałego SOC (z zaimplementowaną kartą graficzną VGA) przeportowałem całą wersję gry "Prince od Persia" (wersja DOS z początku lat 90'tych na komputer PC). SOC został zaimplementowany na płytce FPGA z ujkładem firmy Gowin, którą zaprojektowałem sam około trzech lat temu (dołąćzę takżę projekt płytki PCB dla tego zestawu). Poniżej zamieszczam zdjęcie zestawu FPGA z zaimplementowaną całą grą "Prince of Persia" - gra ma 12 poziomów i około 324 osobnych komnat oraz wiele pułapek i przeciwników. Gra jest zaimplementowana w języku C (program ma około 1013 KB) właśnie na tym SOC. Zacznę może od zestawu FPGA na układzie GW1N-LV9LQ144C6/I5 firmy "Gowin Semiconductors". Układ ten ma 8640 LUT i 6480 przerzutników poniżej podaję link do Mousera z tym układem: https://www.mouser.pl/en/ProductDetail/GOWIN-Semiconductor/GW1N-LV9LQ144C6-I5?qs=wnTfsH77Xs6N%2FyGezJZrJQ%3D%3D Około 3 lat temu zaprojektowałem płytkę PCB z tym układem FPGA oraz układem FTDI do programowania FPGA bez drogiego programatora firmy Gowin oraz układami pamięci SPI Flash i SPI PSRAM i wyjściem VGA oraz wielu pinami FPGA wyprowadzonymi na złącza płytki. Poniżej zamieszczam schemat płytki z FPGA Gowin, oraz projekt PCB w "EasyEDA" wersja standard i pliki Gerber do zamówienia plytki u producenta PCB. Schematic_Gowin_GW1N_LV9_LQ144_DevBoard_SecondEd_2026-10-14.pdf Gerber_SCH_Gowin_GW1N_LV9_LQ144_DevBoard_SecondEd_2026-10-14.zipGowin_GW1N_LV9_LQ144_DevBoard_SecondEd_PCB_Gowin_GW-N_LV9_LQ144_DevBoard_33_Po_2026-10-14.zip Gdy wiec postanowiłem zaimplemantować SOC RISC-V na układzie FPGA miałem do tego idealną platformę sprzętową. Od jakiegoś czasu interesowałem się programowaniem układów FPGA i szczególnie implementacją soft-procesorów na tych układach. Skończyłem chyba 5 kursów na platformie Udemy.com dotyczących projektowania procesorów (lub SOC) zarówno o własnych architekturacjh jak i właśnie RISC-V. Kursy opisywały architekturę własnych procesorów (lub CPU zgodnych z RISC-V przewaznie ISA=riscv32i) ale wiekszość z mich nie korzystała z ogólnie dostepnego kompilatora dla CPU RISCV i często były niejasności w opisie implementacji i architektury CPU. Dopiero ostatnio trafiłem na kurs UDemy gdzie była opisana cała lista rozkazów RISC-V RV32I (32 bitowa operacje stałoprzecinkowe) oraz architektura i implematacja ze wszystkimi szczegółami tak, że nareszcie zrozumiałem wszytstkie szczególy (łącznie z dekoderem instrukcji i układem sterującym CPU). Poza tym był opisany skrypt loadera dla tego CPU, plik startowy i opis kompilacji programu za pomocą ogólno-dostepnego kompilatora RISC-V (RV32I, -march=rv32i). Oraz szczególy ABI, użycia stosu i sterty w programach C. Były też zaimplementowane bench-testy do symulacji wszystkich rozkazów CPU. Był to więc ideqalny kandydat na soft-cpu nad którym miałem całkowitą kontrolę i którego rozumiałem w najmniejszych szczegółach. Do CPU zostały także dodane peryferia jak UART oraz GPIO co właściwie stanowiło cały miniaturowy SOC. Niestety ten SOC miał dużo wad - najważniejsze z nich: mała częstotliwość maksymalna SOC wynosząca dla mojego układu FPGA Gowin około 10Mhz (wynikało to z faktu długich ścieżek układów kombinacyjnych bo układ nie miał zaimplementowanego potoku) pamieć programu wynosiła 280 bajtów a pamięć RAM 90 bajtów (o wiele za mało do praktycznych zastosowań i były te pamięci zaimplementowane w LUT układy FPGA co niepotrzebnie zajmowało zasoby co prawda układ wspierał komilator RISC-V ale nie miał obsługi żadnej biblioteki języka C więć pisząc na niego program nie mieliśmy dostępu do wielu istotnych funkcjijęzyka C. układ nie miał w CPU zaimplementowanej architektury potokowej (pipeline) więc poszczególne fazy wykonywania instrukcji CPU nie mogły zostać zrównoleglone przez co wydajność układu była słaba SOC nie wykorzytywał szybkiej pamięci BRAM z ukadu FPGA dla implementacji pamięci programu oraz RAM SOC nie wykorzystywał zewnetrzehj pamięci SPI FLASH ani SPI PSRAM w celu dalszego zwiększenia pamięci programu i RAM poza pojemność wewnętrznej pamięci BRAM FPGA niektóre części CPU nie były zaimplementaowane najbardziej optymalni (było miejsce do optymalizacji) Tutaj kod programu w języku C który zajmował 280 bajtów i był zaimplementowany w pamięci programu składająćej się z LUT FPGA: #include <stdint.h> #include <stdbool.h> #define reg_uart_clkdiv (*(volatile uint32_t*)0x03000004) #define reg_uart_data (*(volatile uint32_t*)0x03000008) #define reg_leds (*(volatile uint32_t*)0x04000000) void putchar(char c) { if (c == '\n') putchar('\r'); reg_uart_data = c; } void print(const char *p) { for (unsigned i = 0; i < 128 && p[i] != '\0'; i++) putchar(p[i]); } void main() { reg_uart_clkdiv = 520; print("Booting.."); } Program ten po prostu wyświetlał tekst Booting.. poprzez UART. Poniżej podaję link do tego kursu Udemy oraz projket SOC z kursy (bez żadnych modyfikacji)/ https://www.udemy.com/course/build-a-risc-v-cpu-in-vhdl-from-scratch/learn/lecture/54189129?start=285#overview riscv32i_cpu.zip Postanowiłem na bazie tego SOC z kursu mocno rozbudować projket tak aby mógł on mieć zastosowanie w praktycznych projketach elektronicznych. Na poczatek postanowiłem dodać do CPU standardowy 5-fazowy pipeline co powinno umożliwić częściowo równloległe wykonywanie kilku instrukcji procesora (fazy pobierania crozkazu, dekodowania, wykonani zapisu do pamięci i rejestrów). Dodanie potoku powinno dzieki wstawieniu dodatkowych rejestrów skrócić długie ścieżki kombinacyjne w wykonaniu instrukcji i zwięszyć Fmax CPU. Całościowo dodanie potoku powinno mocno zwiększyć wydajność obliczeniową CPU - co jak się okazało po wykonaniu tych zmian miało miejsce. Częstotliwość maksymalna Fmax. dla CPU wzrosła do ponad 20 Mhz z 10 Mhz iwydajność z potokiem wzrosła. Nie będę tu zamieszczał wszystkich projektów pośrednich z faz implementacji i testów na FPGA, tylko dołączę docelowe projekty. W tym samym czasie zamieniłem pamięć programu z implementacji w LUT na wewnętrzne pamięci BRAM FPGA (ten układ FPGA Gowina ma około 50KB BRAM) z czego 32KB przeznaczyłem na pamięć programu a resztę na RAM (także stos i stertę), plik loadera został odpowiednio zmodyfikowany. Potem postanowiłem dodać obsługę biblioteki standardowej języka C - wybór padł tutakj na PicoLi9bc poniewaz jej wersja binarna po kompilacji zaajmuje zaledwie 11 KB. Podaję link do Github projektu tej biblioteki: https://github.com/picolibc/picolibc Poniżej zamieszczam projekt (Gowin FPGA, Firmware) dla wersji SOC z zegarem 20MHz, pamięcią programu oraz RAM ze stosem i stertą w wewnętrzej pamięci BRAM układu FPGA, oraz wkomponowaną biblioteką PicoLibc. W firmware sa napisane w C testy wykonania funkcji z bibliteki standardowej (wyniki dostepne przez UART). Maksymalna pamięć programu (razem z Picolibc która zajmuje 11KB) nie może przekroczyć 32 KB. RISCV_SOC_PICOLIBC_HEAP4K_V1.zip Jak ta wersja zadziałała postanowiłem dodać do SOC kontrolery i obsługę zewnętrznych kostek pamięći SPI Flash (4MB) oraz SPI PSRAM (8MB). Wersja ta miała 16KB cache dla pamieci programu i 4KB cache dla pamięci RAM. Potem dodałem obsługę karty graficznej VGA z framebuferem (buforem całego ekranu w pamięci PSRAM) i buforami dóch linii obrazu w szybkiej pamięci BRAM układu FPGA. Potem zaczęła się aktualizacja i implementacja szybkich transferów z PSRAM i SPI Flash aby zapewnić szybkie odświeżanie obrazu VGA. Na koniec została dodana obsługa prostego kontrolera do konsoli NES z Aliexpress. Poniżej zamieszczam kartę katalogową końcowej wersji SOC, KARTA_KATALOGOWA_RISCV_SOC_GOWIN-1.pdf oraz diagram architektury docelowej wersji. ARCHITEKTURA_SOC_GOWIN-1.pdf Tutaj zamieszczam opis dla 5-cio stopniwego potoku (pipeline) takiego jaki zastosowałem dla tego SOC: Klasyczny, 5-stopniowy pipeline dla procesora RISC (często nazywany pipelinem MIPS) to technika stosowana w celu zwiększenia wydajności procesora poprzez jednoczesne przetwarzanie różnych etapów kilku instrukcji. Oto poszczególne stopnie ułożone w kolejności chronologicznej: 1. IF – Pobranie instrukcji (Instruction Fetch) Opis: Procesor pobiera kolejną instrukcję z pamięci operacyjnej (pamięci podręcznej instrukcji – I-Cache). Działanie: Licznik programu (Program Counter – PC) wskazuje adres instrukcji, która ma zostać pobrana. Po pobraniu instrukcji, wartość PC jest zwiększana, aby wskazywać na kolejną instrukcję w pamięci. 2. ID – Dekodowanie instrukcji (Instruction Decode) Opis: Pobrana instrukcja jest analizowana przez jednostkę sterującą w celu określenia, jaką operację należy wykonać. Działanie: W tym samym czasie z banku rejestrów (Register File) odczytywane są wartości argumentów (rejestrów źródłowych), które będą potrzebne do wykonania tej instrukcji. 3. EX – Wykonanie (Execute) Opis: Następuje faktyczne wykonanie operacji arytmetycznej lub logicznej. Działanie: Główną rolę odgrywa tu jednostka arytmetyczno-logiczna (ALU). Wykonuje ona dodawanie, mnożenie, operacje bitowe itp. W przypadku instrukcji skoków warunkowych, w tym kroku obliczany jest docelowy adres skoku oraz sprawdzany jest warunek. W przypadku instrukcji dostępu do pamięci, ALU oblicza adres komórki pamięci. 4. MEM – Dostęp do pamięci (Memory Access) Opis: Ten etap jest aktywny głównie dla instrukcji, które komunikują się z pamięcią danych (D-Cache). Działanie: Jeśli instrukcja to Load (odczyt), procesor pobiera dane z pamięci pod adresem obliczonym w kroku EX. Jeśli instrukcja to Store (zapis), procesor zapisuje dane do pamięci. Dla zwykłych instrukcji arytmetycznych (np. dodawanie rejestrów) ten etap jest bezczynny – dane są po prostu przekazywane dalej. 5. WB – Zapis zwrotny (Write Back) Opis: Wynik operacji zostaje ostatecznie zapisany w procesorze. Działanie: Dane uzyskane z pamięci (dla instrukcji Load) lub wynik obliczeń z ALU (dla instrukcji arytmetycznych) zostają zapisane z powrotem do docelowego rejestru w banku rejestrów. Po tym etapie wykonywanie instrukcji jest całkowicie zakończone A tutaj link do graficznego przedstawienia potoku i fazy wykonywania każdej z 5-ciu instrukcji (patrz: PIC32MX Pipeline) https://skills.microchip.com/pic32mx-core-architecture/699292 Podaję też link do użytego w projekcie pada NES: https://pl.aliexpress.com/item/1005010461720551.html?spm=a2g0o.productlist.main.9.1dee4c8erthGNb&algo_pvid=5bcda6ea-6c00-45f0-a694-c306506fb623&algo_exp_id=5bcda6ea-6c00-45f0-a694-c306506fb623-8&pdp_ext_f={"order"%3A"380"%2C"eval"%3A"1"%2C"fromPage"%3A"search"}&pdp_npi=6%40dis!PLN!31.89!31.89!!!53.57!53.57!%400b0fed2b17913667944583931e1003!12000052490951864!sea!PL!0!ABX!1!0!n_tag%3A-29910%3Bd%3A472ce1ac%3Bm03_new_user%3A-29895&curPageLogUid=eCtG4taePbtp&utparam-url=scene%3Asearch|query_from%3A|x_object_id%3A1005010461720551|_p_origin_prod%3A Potem przyszedł czas na implementację obsługi zewnętrznych pamięci SPI Flash i SPI PSRAM.Zajeło to trochę czasu zanim wszystko zaczęło zaczęło działać poprawnie (ileś cykli implementacji itestów na układzie FPGA, gdzie testy działąnia były pisane w języku C i wykonywane na CPU).Gdy już pamięci Flash (4MB) i PSRAM (8MB) działay poprawnie postanowiłem zbadać wydajność obliczeniową powstałego CPU. Wybrałem benchmark Dhrystone 2.1 ponieważ był polularny na poczatku lat 90-tych kiedy na rynek weszły procesory ARM2, Intel8086 a trochę óxniej Intel 80386DX 16MHz i dal których znalazłem wyniki tego benchmarku. Wklejam projekt z benchmarkiem - benchmark jest napisany w języku C i wykonywany na naszym CPU - poniżej wklejam projekt: RISCV_SOC_V27_DHRYSTONE21.zip W tym czasie wersja SOC obsługiwała (potwierdzone testami na FPGA): RV32I, pipeline 5-stopniowy, CPU 20 MHz, obsługa oczekiwania na pamięć. SPI Flash 48 MHz, wykonywanie programu przez instruction cache. Picolibc, malloc/free i dane globalne w BRAM — PASS. PSRAM: sprawdzony kontroler V21, odczyt i zapis 24 MHz. Data cache PSRAM: 4 KiB, linie 32 B, direct-mapped, write-back i write-allocate. V25 przeszła 50 000 operacji testowych, TOTAL FAILS=0. Tutaj wyniki benchmarku Dhrystone 2.1 (odczytany z UART SOC): SOC V27 DHRYSTONE 2.1 CPU20 FLASH48 IC16KB DATA=BRAM -O2 NO-LTO NO-BUILTINS TIMER: PASS FLASH: PASS CAL >=2s SAMPLE 1 RUNS 40000 CYCLES 41280067 cycles/Dhrystone: 1032.001 SAMPLE 2 RUNS 40000 CYCLES 41280067 cycles/Dhrystone: 1032.001 SAMPLE 3 RUNS 40000 CYCLES 41280067 cycles/Dhrystone: 1032.001 DHRYSTONE VALIDATION: PASS TOTAL RUNS 120000 TOTAL CYCLES 123840201 seconds: 6.192 Dhrystones/s: 19379.813 DMIPS: 11.030 DMIPS/MHz: 0.551 cycles/Dhrystone: 1032.001 IC H 145929420 M 288 COMPLETE Szczególnie istotny jest tu wiersz: DMIPS: 11.030 A tutaj porównanie do procesorów z tatmej epoki (poczatek lat 90-tych): Benchmark przeszedł na rzeczywistym FPGA — V27 poprawnie wykonuje Dhrystone 2.1. ParametrWynik CPU20 MHz Dhrystones/s19 379,813 DMIPS11,030 DMIPS/MHz0,5515 Cykle na iterację1032,002 Łączny czas pomiaru6,192 s Wszystkie trzy próbki mają dokładnie tę samą liczbę cykli. To bardzo dobra powtarzalność dla tego obciążenia z rozgrzanym cache. Każda trwała około 2,064 s, więc kalibracja działa prawidłowo. DHRYSTONE VALIDATION: PASS potwierdza poprawność końcowych wartości obliczeń. Mamy teraz zmierzoną wydajność naszego SoC: około 11,03 DMIPS przy 20 MHz, dla kompilacji -O2, kodu wykonywanego z Flash przez cache i danych w BRAM. DMIPS to umowna miara Dhrystone — nie oznacza 11 milionów instrukcji RISC-V na sekundę. Tabelka porównawcza: Nasz SoC 20 MHz wypada wyraźnie szybciej od tych trzech konfiguracji w dostępnych wynikach Dhrystone. Porównanie jest orientacyjne — historyczne pomiary używają różnych kompilatorów i wersji benchmarku. ProcesorWynik historyczny, przeliczony na DMIPS¹Nasz SoC względem tego wyniku Nasz RV32I 20 MHz 11,03 — Dhrystone 2.11× ARM2 8 MHzokoło 3,11–3,40około 3,2–3,5× szybszy Intel 8086 5 MHzokoło 0,24–0,28, szacunekokoło 40–45× szybszy Intel 80386DX 16 MHzokoło 3,19–3,49 około 3,2–3,5× szybszy Czayli nasz SOC jest około 3,5 razy wydajniejszy od ARM2 8Mhz, 46 razy szybszy od Intel8086 5Mhz i 3,5 razy szybszy od Intel 80386Dx 16Mhz. Praktycznie: uzyskaliśmy wydajność naszego SOC istotnie przekraczającą te konkretne historyczne wyniki ARM2/8 i 386DX/16. Nie należy jednak przenosić mnożnika „około 3×” wprost na gry — nasz pomiar wykorzystuje rozgrzany instruction cache i dane w BRAM, więc nie pokazuje kosztów pracy z dużymi buforami w PSRAM. Oryginalny DOOM dało się uruchomić na Intel 80386DX 16 MHz, mając minimum 4 MB RAM i kartę VGA. Oficjalne wymagania id Software dopuszczały procesor 386, choć zalecano 486. Po uzyskaniu tej informacji postanowiłe wykonać test SOC "w boju" portując na niego jakąś fajną grę z poczatku lat 90-tych. Wybór padł na "Prince of Persia" wersja pod DOS (gra działała na Intel80386DX 16MHz) oraz potrzebuje okolo 1,5 MB na program Ci grafiki poziomów. Gra była dość mocno przełomowa w tamtym czasie. W tym czasie gdy program w języku C nie przekraczał 32KB (razem z kodem biblioteki Picolibc 11KB) program do wykonania na CPU był ładowany cały do pamieci BRAM. Natomiast gdy program przekraczał 32KB był ładowany do pamięci zwenętrznej SPI Flash i ładowany porcjami po 16KB do cache programu. W module top projektu FPGA w VHDL był generic o nazwie SMALL_PROG, gdy jego wartość była true to program był ładowany do pamięci BRAM, gdy false to do zewnętrznej pamięci Flash - patrz kod poniżej: entity top is generic ( G_FPGA : boolean := true; -- false for simulation, true for FPGA SMALL_PROG : boolean := false; -- RUN mode: execute integration program from Flash CACHE_SIZE_BYTES : positive := 16384 ); port ( clk : in std_logic; resetn : in std_logic; ser_tx : out std_logic; ser_rx : in std_logic; leds : out std_logic_vector(7 downto 0); flash_cs_n, flash_sclk, flash_mosi : out std_logic; flash_miso : in std_logic; psram_cs_n, psram_sclk, psram_mosi, psram_io2, psram_io3 : out std_logic; psram_miso : in std_logic ); end entity top; Dalszę część postu napiszę jutroc - teraz muszę spadać do domu